سرچ کنسول یه ابزار رایگان فوقالعادهست، اما محدودیتهای خیلی جدیای تو زمینه داده و ایندکس کردن داره. تو این مطلب بهت یاد میدم چطور کاری کنی که بیشتر برات کار کنه.
خلاصه کلام
- سرچ کنسول محدودیتهای خیلی جدیای تو زمینه ذخیرهسازی، دادههای ناقص و ناشناس، و محدودیتهای API داره.
- با ساختن پراپرتیهای خیلی بیشتر تو سطح سابفولدر (subfolder)، میتونی خیلی از این محدودیتها رو دور بزنی و کاری کنی که سرچ کنسول خیلی بیشتر برات کار کنه.
- تو اکانت سرچ کنسولت میتونی تا ۱۰۰۰ تا پراپرتی داشته باشی. پس به یه پراپرتی سطح دامنه قانع نباش.
- همه این کارا باعث میشه تحلیلهای خیلی غنیتری در سطح ایندکس، کوئری و صفحه داشته باشی. همهش هم رایگانه. مخصوصاً اگه از سقف ایندکس ۲۰۰۰ URL از طریق API برای هر پراپرتی استفاده کنی.
 منبع عکس: Harry Clarkson-Bennett
خب، این روش بیشتر برای سایتهای خیلی بزرگه (Enterprise). سایتهایی که ساختار سابفولدر عمیقی دارن و کلی محتوا منتشر کردن. البته این موضوع فقط مختص ناشرها نیست. اگه تو یه برند فروشگاهی کار میکنی، این روش میتونه فوقالعاده برات مفید باشه.
من و این روش، عاشق همه سایتهای بزرگ و سنگین هستیم، فرقی هم نمیکنه کدوم باشه.
پراپرتی سرچ کنسول چیه؟
پراپرتی سرچ کنسول یه دامنه، سابفولدر یا سابدامین از یه وبسایته که میتونی ثابت کنی مال توئه.
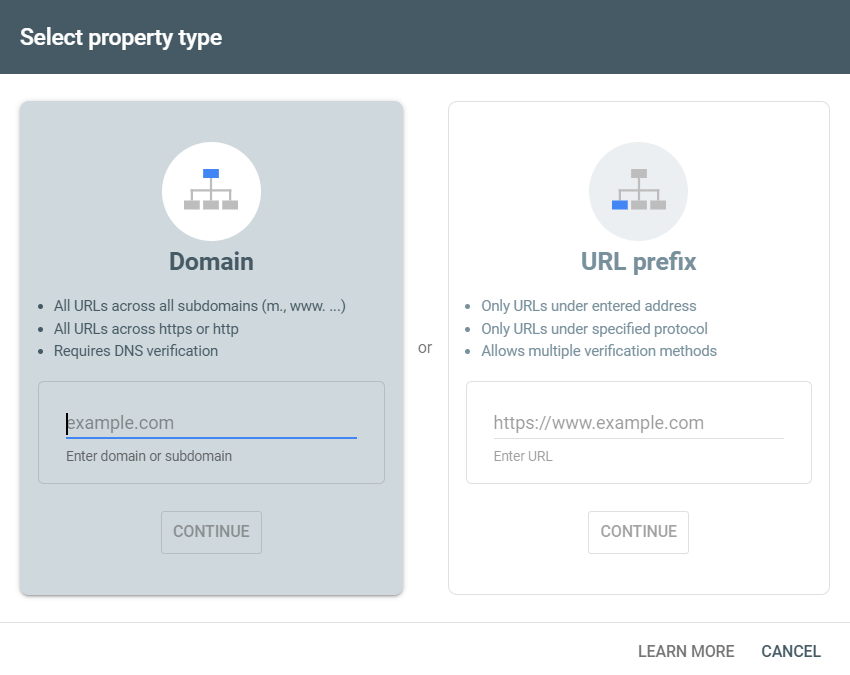 میتونی پراپرتیهای سطح دامنه یا سطح پیشوند URL بسازی (منبع عکس: Harry Clarkson-Bennett)
اگه فقط یه پراپرتی سطح دامنه بسازی، باز هم به همه چیزای خوب سرچ کنسول دسترسی داری. مثلاً دادههای کلیک و ایمپرشن، تحلیل ایندکس شدن و گزارش آمار خزش (crawl stats report) که فقط تو پراپرتیهای سطح دامنه موجوده. اما با یه سری محدودیتهای خیلی جدی روبرو میشی:
- ۱۰۰۰ ردیف داده در سطح کوئری و صفحه.
- محدودیت روزانه ۲۰۰۰ URL در API برای تحلیل سطح ایندکس.
- دادههای کلمات کلیدی نمونهبرداری شده (و مخفیسازی به دلیل حریم خصوصی).
- دادههای از دست رفته (تو بعضی موارد ۷۰ درصد یا بیشتر).
- دادههای فقط برای ۱۶ ماه گذشته.
با اینکه برای دور زدن محدودیت ۱۶ ماهه و دادههای نمونهبرداری شده باید دادههات رو به BigQuery اکسپورت کنی (یا از یکی از ابزارهای زیر استفاده کنی)، اما میتونی با استفاده بهتر از پراپرتیها، تجربه کار با سرچ کنسول رو به طرز چشمگیری بهتر کنی.
چندین روش برای تأیید مالکیت وجود داره؛ مثل تأیید DNS، تگ HTML یا آپلود فایل، و کد رهگیری گوگل آنالیتیکس. وقتی یه پراپرتی سطح دامنه رو ساختی و تأییدش کردی، دیگه راحت میتونی هر پراپرتی زیرمجموعهش رو اضافه کنی؛ چه سابدامین باشه چه سابفولدر.
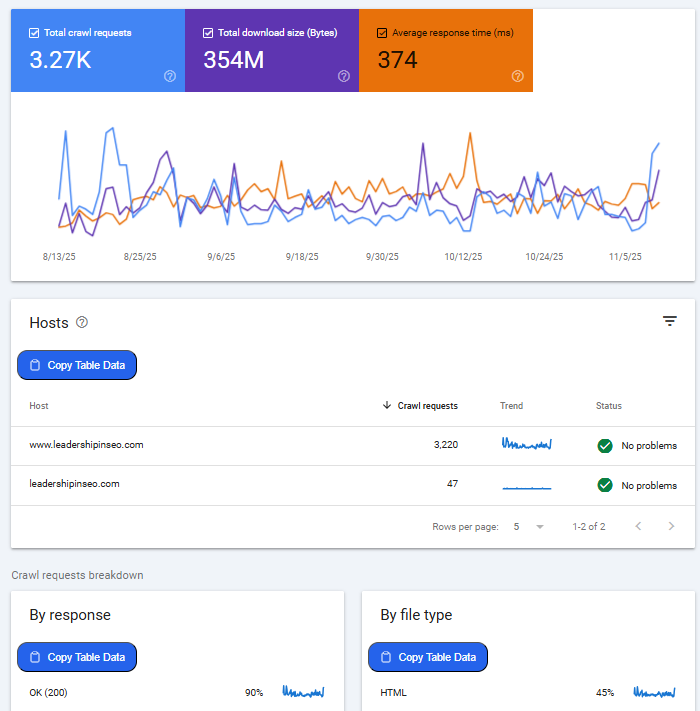 گزارش آمار خزش میتونه یه گنج واقعی باشه، مخصوصاً برای سایتهای بزرگ (البته نه این یکی!) (منبع عکس: Harry Clarkson-Bennett)
گزارش آمار خزش برای دیباگ کردن مشکلاتی مثل افزایش ناگهانی URLهای پارامتردار یا سابدامینهای دردسرساز، فوقالعاده مفیده. مخصوصاً تو سایتهای بزرگی که بخشهای مختلف کارایی میکنن که من و تو تا وقتی کار از کار نگذشته ازشون خبردار نمیشیم.
اما با بررسی تغییرات در سطح هاست، نوع فایل و کد پاسخ (response code)، میتونی جلوی مشکلات رو از ریشه بگیری. به راحتی میتونی مسائلی که روی بودجه خزش (crawl budget) تو تأثیر میذارن رو پیدا کنی، قبل از اینکه بخوای به خاطر رویکردشون تو لینکسازی داخلی و URLهای پارامتردار، سر یکی رو به دیوار بکوبی.
البته معمولاً اینطوریه. بعضی وقتا واقعاً لازمه یه پسگردنی محکم به بعضیا بزنی. البته استعاری گفتم ها!
سابدامینها معمولاً به عنوان موجودیتهای جداگانه با بودجه خزش مخصوص به خودشون در نظر گرفته میشن. اما همیشه اینطور نیست. به گفته جان مولر، این امکان وجود داره که گوگل سابدامینهای شما رو برای اهداف بودجه خزش با هم گروهبندی کنه.
به گفته گری ایلیش، بودجه خزش معمولاً بر اساس نام هاست (host name) تعیین میشه. بنابراین اگه نام هاست سابدامینها از دامنه اصلی جدا باشه، باید بودجه خزش خودشون رو داشته باشن.
چطور پراپرتیهای مناسب رو پیدا کنم؟
به عنوان یه سئوکار، وظیفه تو اینه که وبسایت رو بهتر از هر کس دیگهای بشناسی. تو بیشتر موارد، این کار خیلی هم سخت نیست، چون معمولاً با کسایی کار میکنی که از دنیای دیجیتال بیخبرن. معمولاً میتونی این دادهها رو تو خود سرچ کنسول پیدا کنی. اما سایتهای بزرگتر یه کم توجه بیشتری لازم دارن.
سایتت رو با ابزارهایی مثل Screaming Frog، Sitebulb یا Lumar (همون Deepcrawl سابق) کراول کن و اگه از قبل ساختار سایتت رو نمیشناسی، یه تصویر کلی ازش به دست بیار. اول باارزشترین پراپرتیها رو اضافه کن (اول درآمد، بعد ترافیک) و از همونجا ادامه بده.
چند تا جایگزین برای سرچ کنسول
قبل از اینکه ادامه بدیم، بیانصافیه اگه به چند تا جایگزین عالی برای سرچ کنسول اشاره نکنم. جایگزینهایی که این محدودیتها رو به طور کامل برات حذف میکنن.
SEO Stack
SEO Stack یه ابزار فوقالعادهست که تمام محدودیتهای کوئری رو حذف میکنه و یه ساختار داخلی داره که میتونی واقعاً با دادههات حرف بزنی. مثلاً، به من محتوایی رو نشون بده که همیشه تو شهریور عملکرد خوبی داشته، یا صفحاتی رو پیدا کن که پروفایل کوئری سالمی دارن.
دنیل خیلی درباره شمارش کوئری (query counting) صحبت کرده و این روش یه راه عالی برای فهمیدن اینه که سایت یا محتوای تو تو نتایج جستجو به کدوم سمت میره. بالا رفتن تو ۳ یا ۱۰ نتیجه اول خوبه، پایین اومدن تو این رتبهها و بالا رفتن تو رتبههای پایینتر بده.
SEO Gets
SEO Gets یه جایگزین اقتصادیتر برای SEO Stack هست (که البته خودشم اونقدر گرون نیست). SEO Gets هم محدودیتهای استاندارد ردیفهای سرچ کنسول رو حذف میکنه و تحلیل محتوا رو خیلی کارآمدتر میکنه.
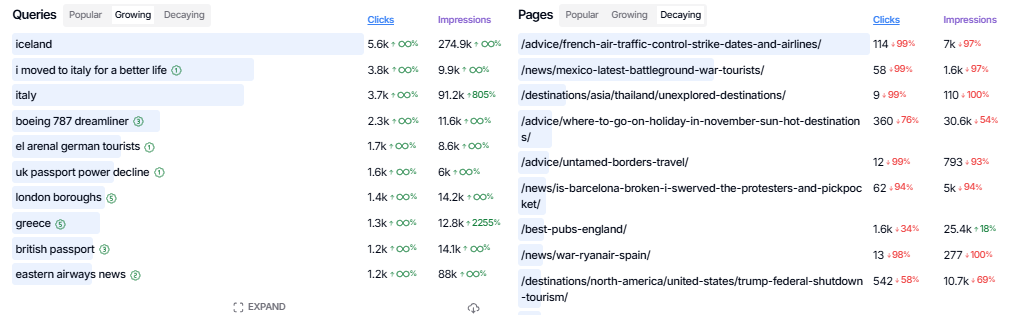 بخش صفحات و کوئریهای در حال رشد و در حال افت تو SEO Gets فوقالعاده کاربردیه (منبع عکس: Harry Clarkson-Bennett)
میتونی گروههای کلمات کلیدی و صفحه برای شمارش کوئری و تحلیل کلیک و ایمپرشن در سطح خوشههای محتوایی (content cluster) بسازی. میشه گفت SEO Gets بهترین نسخه رایگان رو بین تمام ابزارهای بازار داره.
Indexing Insight
Indexing Insight – ابزار تحلیل ایندکس فوقالعاده دقیق آدام جنت – برای وبسایتهای بزرگ و پراکنده یه نجاتدهندهست. محدودیت ۲۰۰۰ URL در روز برای سایتهای بزرگ اصلاً کافی نیست. اما با استفاده هوشمندانه از رویکرد چند پراپرتی، میتونی از سقف ۲۰۰۰ URL *برای هر پراپرتی* استفاده کنی.
با وجود یه سری تصویرسازیها و دادههای عالی (میدونستی اگه یه URL به مدت ۱۳۰ روز کراول نشه، از ایندکس گوگل حذف میشه؟)، به یه راهکار مثل این نیاز داری. مخصوصاً برای سایتهای قدیمی و بزرگ.
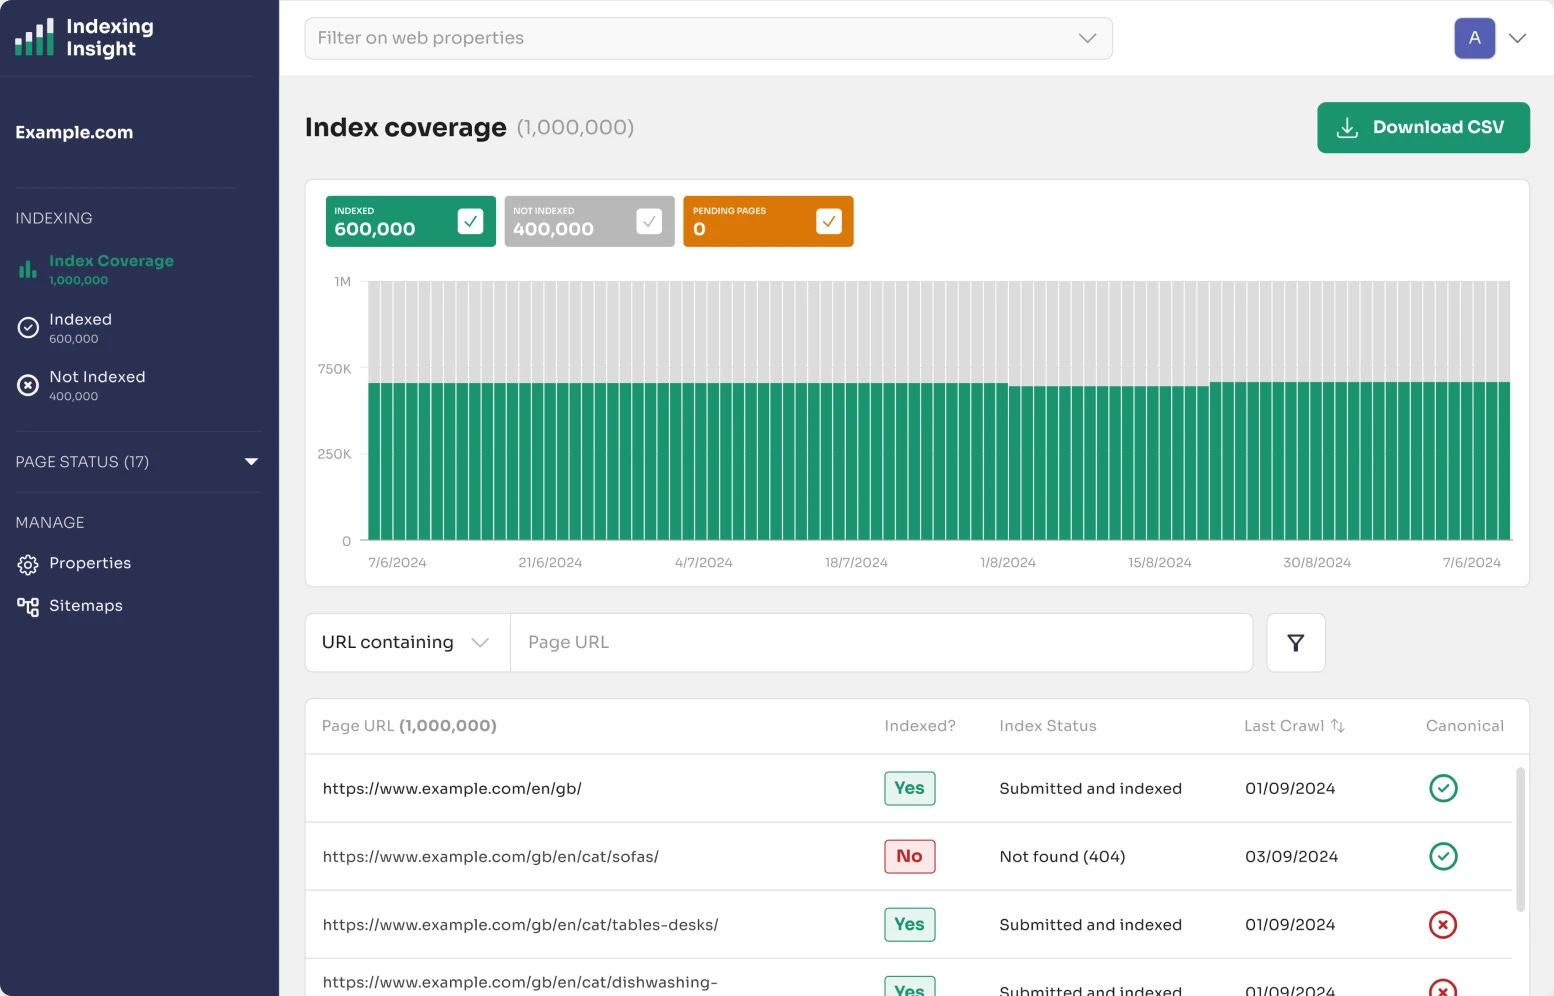 با استفاده از API محدودیت ایندکس ۲۰۰۰ URL در روز و محدودیت ۱۰۰۰ ردیف URL رو حذف کن (منبع عکس: Harry Clarkson-Bennett)
همه این ابزارها فوراً تجربه کار با سرچ کنسول رو برات بهتر میکنن.
مزایای رویکرد چند پراپرتی
میشه گفت مؤثرترین راه برای دور زدن بعضی از مشکلات بالا، افزایش تعداد پراپرتیهاییه که داری. به دو دلیل اصلی: هم رایگانه و هم محدودیتهای اصلی API رو دور میزنه.
همه از چیزای رایگان خوششون میاد. یه بار از کنار یه دکهای رد میشدم که روز افتتاحش بود و داشتن قوطی گوجه فرنگی خرد شده مجانی میدادن. خیلی عجیب بود. عجیبتر از اون این بود که مردم صف کشیده بودن. صفی که منم تهش وایسادم.
اسپاگتی بلونز هیچوقت اینقدر بهم نچسبیده بود.
ردیابی دقیقتر ایندکس
میشه گفت یکی از بهترین اما محدودترین ویژگیهای سرچ کنسول، تحلیل ایندکس اونه. فهمیدن تفاوت بین Crawled – Currently Not Indexed و Discovered – Currently Not Indexed میتونه بهت کمک کنه تصمیمات هوشمندانهای بگیری که کارایی سایتت رو بهتر میکنه و استراتژیهای بودجه خزش و لینکسازی داخلی تو رو به طور قابل توجهی بهبود میده.
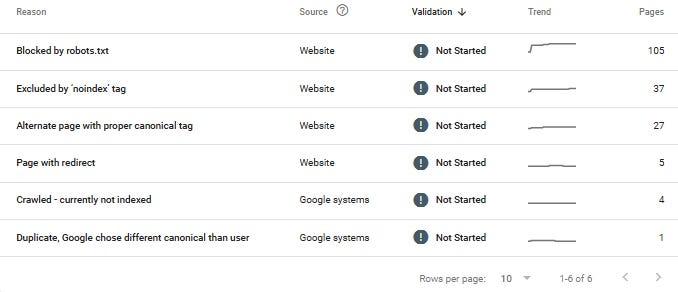 منبع عکس: Harry Clarkson-Bennett
صفحاتی که تو وضعیت Crawled – Currently Not Indexed قرار میگیرن، ممکنه به اقدام فوری نیازی نداشته باشن. صفحه کراول شده، اما برای ایندکس گوگل مناسب تشخیص داده نشده. این میتونه نشونه مشکلات کیفیت صفحه باشه، پس ارزشش رو داره که مطمئن بشی محتوات ارزش افزوده ایجاد میکنه و لینکسازی داخلی تو صفحات مهم رو در اولویت قرار میده.
وضعیت Discovered – Currently Not Indexed یه کم فرق میکنه. معنیش اینه که گوگل URL رو پیدا کرده، اما هنوز کراولش نکرده. ممکنه حجم تولید محتوای تو با ارزشی که گوگل برای سایتت قائله، همخونی نداشته باشه. یا اینکه ساختار لینکسازی داخلی تو باید محتوای مهم رو بهتر در اولویت قرار بده. یا شاید هم یه مشکل فنی یا سروری وجود داره.
همه اینا حداقل به یه درک اولیه از نحوه کار خط لوله ایندکس گوگل نیاز داره. این یه رویکرد صفر و یکی نیست. گری ایلیش گفته که گوگل یه سیستم لایهبندی شده برای ایندکس داره. محتوایی که باید بیشتر نمایش داده بشه، تو یه سیستم باکیفیتتر و گرونتر ذخیره میشه. محتوای کمارزشتر تو یه سیستم ارزونتر ذخیره میشه.
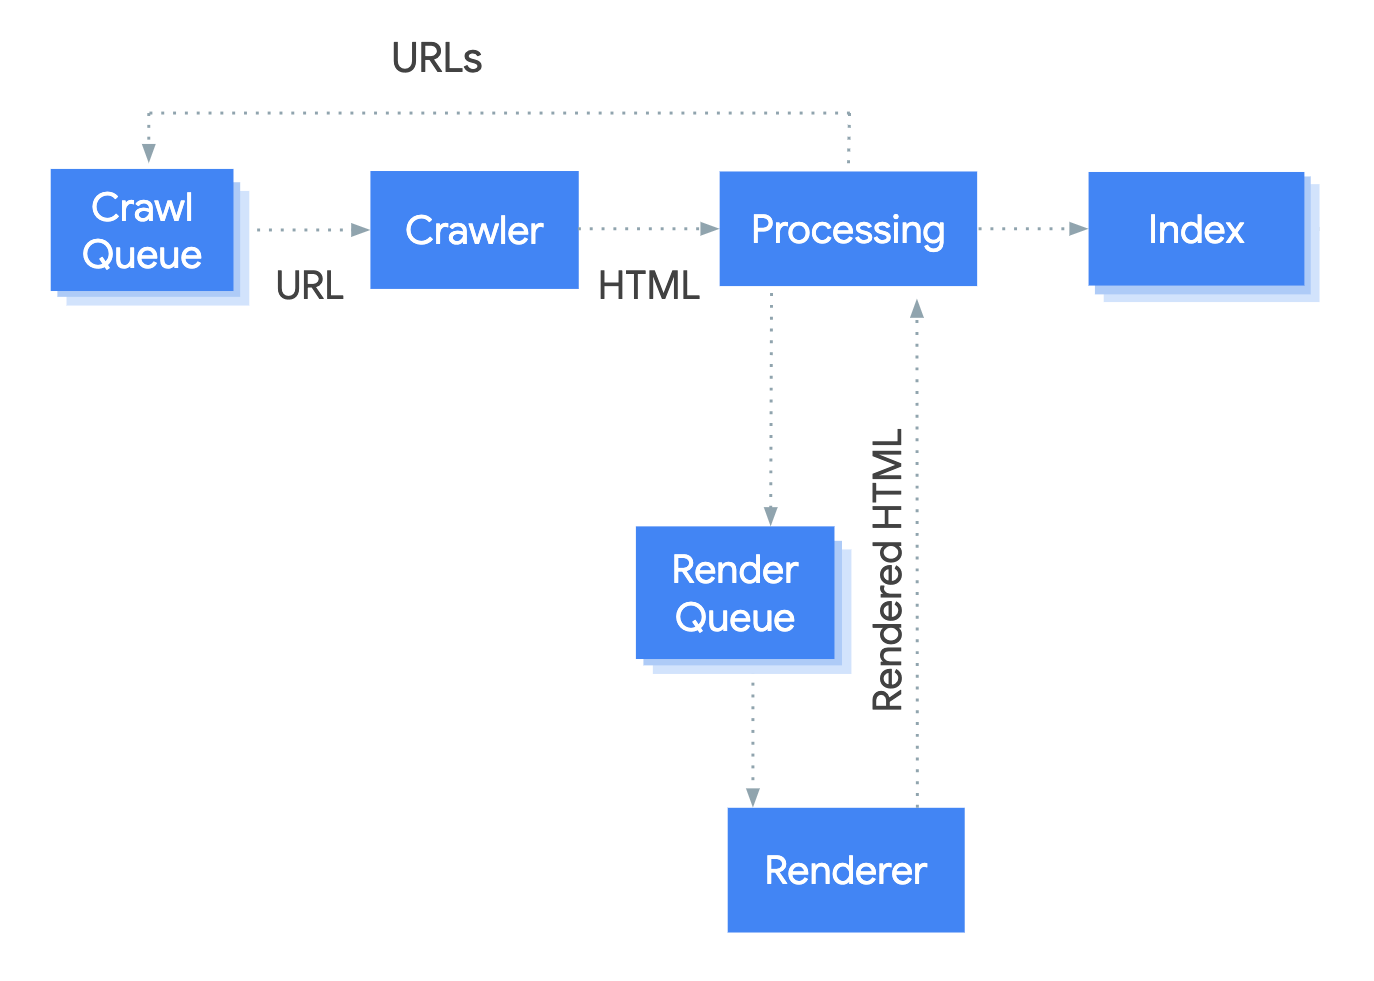 نحوه کار سیستم کراول و رندر گوگل (منبع عکس: Harry Clarkson-Bennett)
دیگه قضیه این نیست که هر چی ببینه رو همون کار رو انجام بده؛ بلکه میبینه، و بر اساس ارزش سایت، بودجه خزش، کارایی، بار سرور و استفاده از جاوا اسکریپت تصمیم میگیره.
رویکرد لایهای برای ایندکس، ارزش درک شده و HTML خام یه صفحه رو در اولویت قرار میده. جاوا اسکریپت تو صف قرار میگیره چون منابع خیلی بیشتری مصرف میکنه. به همین دلیله که سئوکارها اینقدر اصرار دارن که محتوات در سمت سرور رندر بشه.
آدام یه راهنمای خیلی خوب درباره انواع صفحات ایندکس نشده در سرچ کنسول و معنی هر کدوم اینجا داره.
بد نیست بدونی که ابزار ایندکس صفحه کاملاً بهروز نیست. فکر میکنم هفتهای چند بار آپدیت میشه. اما یادم نیست این اطلاعات رو از کجا آوردم، پس خیلی رو حرفم حساب نکن…
اگه یه ناشر خبری بزرگ باشی، خیلی از محتواهای خبریت رو تو دسته Crawled – Currently Not Indexed میبینی. اما وقتی URL رو اینسپکت میکنی (که حتماً باید این کار رو بکنی) ممکنه ببینی ایندکس شده. یه تأخیری وجود داره.
مقیاسپذیری Indexing API
وقتی شروع به کار روی وبسایتهای بزرگتر میکنی – منظورم وبسایتهاییه که سابفولدرهاشون بالای ۵۰۰ هزار صفحه دارن – محدودیت ۲۰۰۰ URL در API خودشو نشون میده. просто نمیتونی به طور مؤثر صفحاتی که وارد بخش «چرا صفحات ایندکس نشدهاند؟» میشن یا ازش خارج میشن رو شناسایی کنی.
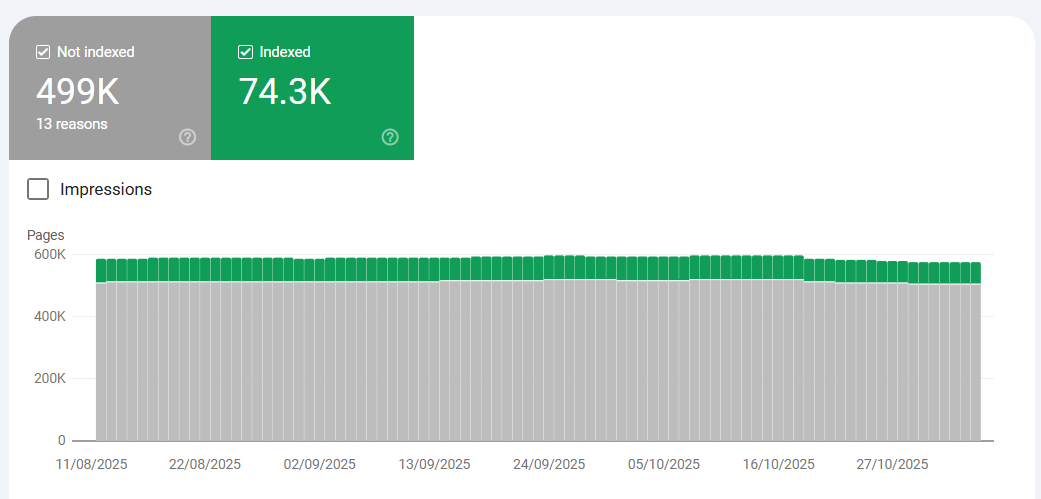 خیلی خوب نیست، ولی بدتر از این هم دیدم (منبع عکس: Harry Clarkson-Bennett)
اما وقتی چندین پراپرتی راهاندازی میکنی، میتونی به طور مؤثر مقیاسپذیرش کنی.
محدودیت ۲۰۰۰ تایی فقط در سطح پراپرتی اعمال میشه. پس اگه یه پراپرتی سطح دامنه رو در کنار ۲۰ تا پراپرتی دیگه (در سطح سابفولدر) راهاندازی کنی، میتونی تا ۴۲,۰۰۰ URL در روز استفاده کنی. هر چی بیشتر باشه، بهتره.
و API مزایای دیگهای هم داره:
- میتونی درخواست ایندکس یا حذف URLهای خاصی رو بدی (باز هم با محدودیت ۲۰۰۰ تا در روز).
- میتونی وقتی صفحهای منتشر یا حذف میشه، نوتیفیکیشنهای آنی بفرستی. مثل IndexNow بینگ.
- ایندکس شدن محتوای حساس به زمان رو سریعتر میکنه.
اما ایندکس شدن رو تضمین نمیکنه. این یه درخواسته، نه یه دستور.
برای راهاندازیش، باید API رو تو Google Cloud Console فعال کنی. میتونی از این راهنمای سریع که نصفه و نیمه مفیده، پیروی کنی. راهاندازیش هم اصلاً کار مفرحی نیست. رسماً دهن آدمو سرویس میکنه. ولی ارزشش رو داره. بعدش به یه اسکریپت پایتون نیاز داری تا درخواستهای API رو بفرستی و سهمیهها و پاسخهای API (2xx, 3xx, 4xx و غیره) رو نظارت کنی.
اگه میخوای کار رو حرفهایتر کنی، میتونی این دادهها رو با دادههای انتشار محتوات ترکیب کنی تا دقیقاً بفهمی صفحات تو بخشهای خاص چقدر طول میکشه تا ایندکس بشن. و تو *همیشه* باید بخوای که کار رو حرفهای انجام بدی.
این یه سیگنال خیلی خوب برای اینه که بفهمی مهمترین سابفولدرهات از نظر گوگل کدومان. دستهبندیهای با عملکرد بالا در مقابل دستهبندیهای با عملکرد ضعیف.
دادههای دقیقتر کلیک و ایمپرشن
این یکی برای سایتهای بزرگ ضروریه. سرچ کنسول پیشفرض نه تنها فقط ۱۰۰۰ ردیف از دادههای کوئری و URL رو ذخیره میکنه، بلکه فقط برای ۱۶ ماه این کار رو میکنه. با اینکه زمان زیادی به نظر میاد، اما یکی دو سال که بگذره، آرزو میکنی کاش از همون اول دادهها رو تو BigQuery ذخیره کرده بودی.
مخصوصاً وقتی میخوای رفتار کلیک سال به سال (YoY) و برنامهریزی برای رویدادها رو بررسی کنی. فقط همون دندونقروچهای که از حرص میری، خرج سفر سالانه دندونپزشکت به جزایر قناری رو درمیاره.
اما راحتترین راه برای دیدن دادههای جستجو با جزئیات بیشتر، ساختن پراپرتیهای بیشتر تو سرچ کنسوله. با اینکه هنوز همون محدودیتهای کوئری و URL رو داری، اما چون به جای یکی، چندین پراپرتی داری، این محدودیتهای داده خیلی کمتر به چشم میاد.
نقشههای سایت (Sitemaps) چی؟
این موضوع مستقیماً به ایندکس سرچ کنسول مربوط نمیشه، اما نکته قابل توجهیه. سایتمپها ابزار خیلی قدرتمندی برای تشویق به ایندکس شدن محتوا نیستن. ایندکس شدن محتوا به این بستگی داره که چقدر برای کاربرها «مفید» باشه.
البته، بیانصافیه اگه نگم که سایتمپهای خبری یه کم فرق دارن. وقتی سرعت انتشار و ایندکس شدن خیلی مهمه، باید جدیدترین مقالههات رو تو یه جای مشخص و تأیید شده، برجسته کنی.
در نهایت، همه چیز به Navboost برمیگرده. کلیکهای خوب در مقابل کلیکهای بد و آخرین طولانیترین کلیک. یا تو حوزه خبر، به Glue مربوط میشه – یه جدول عظیم از تعاملات کاربر که برای رتبهبندی محتوای تازه در لحظه و *پویا* نگه داشتن ایندکس طراحی شده. ایندکس شدن به این بستگی داره که محتوای تو برای کاربرها اونقدر ارزشمند باشه که گوگل به ذخیره کردنش تو ایندکس خودش ادامه بده.
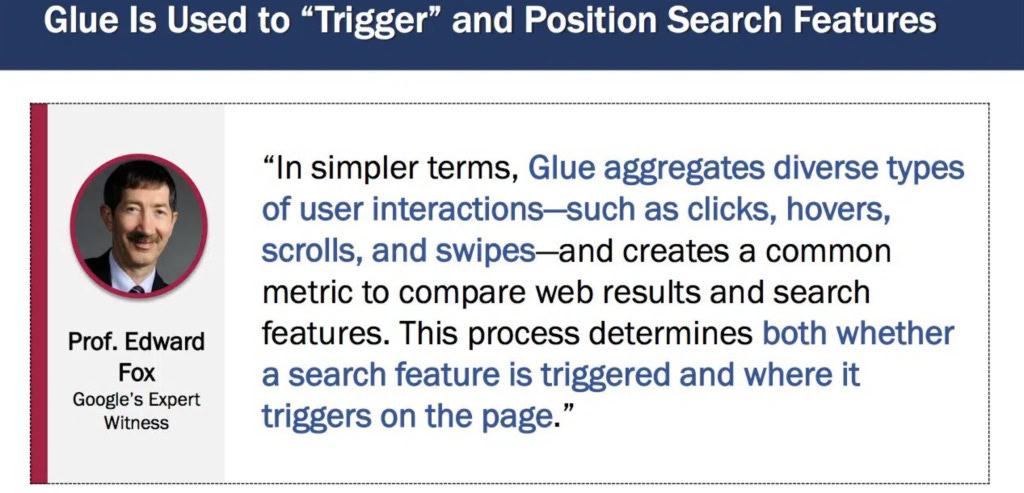 Glue برای بازخورد فوریتر، روی سیگنالهای تعامل آنی مثل هاور کردن و سوایپ کردن تأکید داره (منبع عکس: Harry Clarkson-Bennett)
به لطف دههها تجربه (و تأییدش در دادگاه وزارت دادگستری آمریکا و افشای اطلاعات گوگل)، میدونیم که اعتبار سایت شما (Q*)، تأثیرش در طول زمان و ساختار لینکسازی داخلی، همگی نقش کلیدی دارن. اما وقتی محتوا ایندکس شد، همه چیز به تعامل کاربر بستگی داره. چه سایتمپ داشته باشی چه نداشته باشی، نمیتونی مردم رو مجبور کنی عاشق محتوای بیروح و کسلکنندهت بشن.
نقشههای سایت ایندکس (Sitemap Indexes) چطور؟
بیشتر سایتهای بزرگ از سایتمپ ایندکس استفاده میکنن. در واقع، یه سایتمپ از سایتمپها برای مدیریت وبسایتهای بزرگتر که از محدودیت ۵۰,۰۰۰ ردیف فراتر میرن. وقتی سایتمپ ایندکس رو تو سرچ کنسول آپلود میکنی، به همینجا بسنده نکن. تکتک سایتمپهای داخل سایتمپ ایندکست رو هم آپلود کن.
این کار بهت امکان دسترسی به وضعیت ایندکس در سطح هر سایتمپ رو تو گزارش ایندکس صفحه یا گزارش سایتمپها میده. چیزی که مدیریتش وقتی میلیونها صفحه تو یه سایتمپ ایندکس داری، خیلی سختتره.
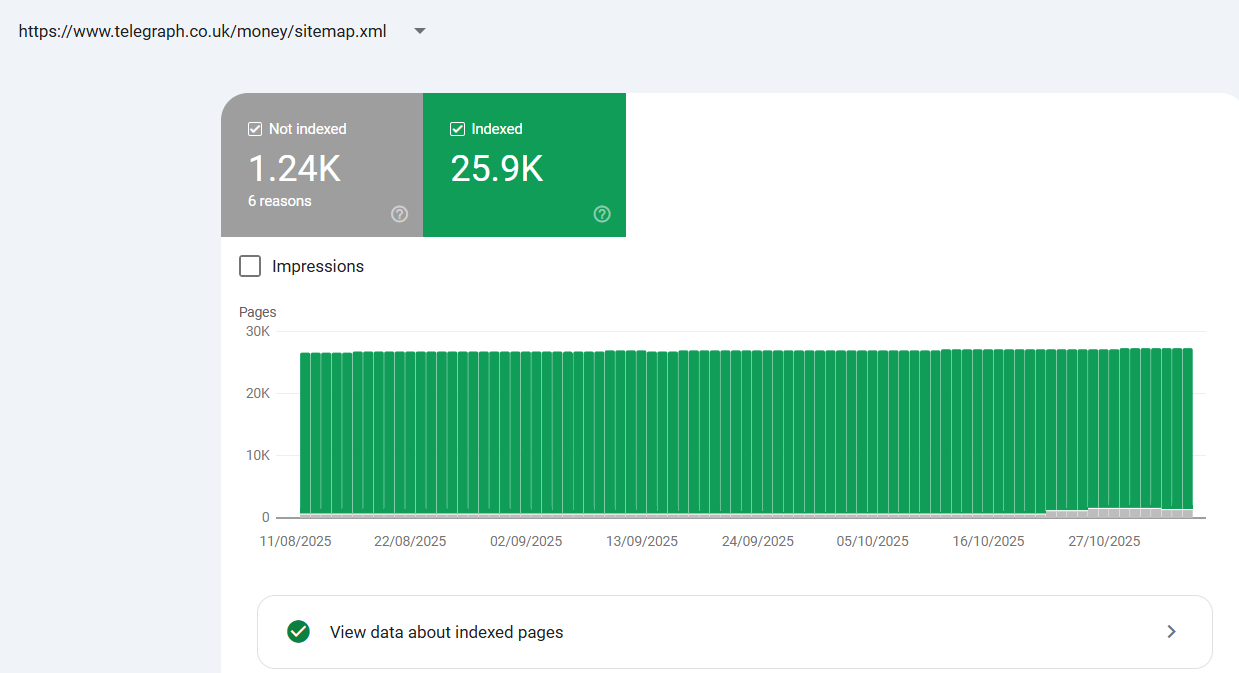 دیدن دادهها در سطح هر سایتمپ، دادههای دقیقتری از وضعیت ایندکس تو سرچ کنسول بهت میده (منبع عکس: Harry Clarkson-Bennett)
همون رویکردی که در مورد پراپرتیها گفتیم رو در مورد سایتمپها هم در پیش بگیر. بیشتر، معمولاً بهتره.
بد نیست بدونی که به هر سند هم یه DocID اختصاص داده میشه. DocID سیگنالهایی رو برای امتیازدهی به محبوبیت صفحه ذخیره میکنه: کلیکهای کاربر، کیفیت و اعتبارش، دادههای خزش و یه امتیاز اسپم و موارد دیگه.
هر چیزی که برای رتبهبندی یه صفحه حیاتی تشخیص داده بشه، برای اهداف ایندکس و رتبهبندی ذخیره و استفاده میشه.
خب، حالا باید چیکار کنم؟
- تنظیمات فعلی سرچ کنسولت رو ارزیابی کن – آیا به اندازه کافی برات کار میکنه؟
- به یه پراپرتی سطح دامنه و گزارش آمار خزش دسترسی داری؟
- آیا قبلاً سایتت رو به «پراپرتیها»ی مختلف تو سرچ کنسول تقسیم کردی؟
- اگه نه، سایتت رو کراول کن و سابفولدرهایی که میخوای اضافه کنی رو مشخص کن.
- تنظیمات سایتمپت رو بازبینی کن. فقط یه سایتمپ ایندکس داری؟ آیا سایتمپهای تکی رو هم به سرچ کنسول اضافه کردی؟
- به این فکر کن که دادههات رو به BigQuery وصل کنی و بیشتر از ۱۶ ماه ذخیرهشون کنی.
- به این فکر کن که از طریق Google Cloud Console به API وصل بشی.
- ابزارهای بالا رو بررسی کن و ببین آیا میتونن برات ارزش افزوده ایجاد کنن.
در نهایت، سرچ کنسول خیلی مفیده. اما محدودیتهای قابل توجهی داره و خب، باید منصف باشیم، رایگانه. ابزارهای دیگه از خیلی جهات ازش پیشی گرفتن. اما حداقل کاری که میتونی بکنی اینه که کاری کنی تا جایی که ممکنه برات کار کنه.